聊天提炼知识库操作说明(群聊与私聊)
更新时间:2026 年 10 月 12 日
「聊天提炼知识」将指定微信群或好友私聊、指定时间范围内的讨论整理为问答草稿。草稿不会被客服使用;人工审核并确认入库后,知识才参与检索。
使用前准备:授权版与试用版
| 项目 | 有效授权版 | 试用版 |
|---|---|---|
| 明文库离线提炼 | 支持 | 不支持 |
| 选择聊天数量 | 不设上限 | 最多 30 个 |
| 日期跨度 | 不设上限,可留空或选全部日期 | 最多 30 天,必须填写起止时间 |
| 聊天记录总量 | 不设上限,分批读取处理 | 最多 10000 条 |
| 微信登录及客服服务 | 明文库模式均无需 | 仍需当前微信账号连接、客服服务与调度器 |
两种版本都需要配置 AI 服务,提炼结果仍需审核后确认入库。授权及租约需有效;后端在提交和执行时校验,不能通过修改页面参数绕过限制。
授权版默认使用「解密后的明文库(离线)」。填写单个账号的解密目录并点击「加载明文库」,例如 E:\decrypted\账号目录,其中应包含 contact/contact.db 与 message/message_*.db;也兼容该目录下另有 db_storage 一层的结构。不同账号分别创建任务,不把多个账号目录混在一起读取。
已有明文库无需密钥。只有原始加密库时,还需要本地数据库文件和对应密钥,到「解密数据库」完成解密后再加载。已保存密钥的解密与后续明文提炼均不需要启动客服服务或登录微信;首次取得密钥仍依赖现有密钥提取流程。明文库只读,不写入微信来源数据库。
授权版也可以选「微信原始库(客服服务连接)」,该模式仍需要连接,但同样取消上述总量限制。试用版保持原实时库流程:登录微信,启动客服服务,在设置中启用调度器,刷新当前账号聊天列表。
此功能自身不会发送微信消息。明文模式的后台执行器运行在 UI 后端,不启动客服服务或微信发送模块。关闭提炼页面不会停止任务;退出整个程序会中断正在执行的任务,重新打开后会标记中断,可重试未完成部分。排队任务会继续处理。
选择聊天和时间范围
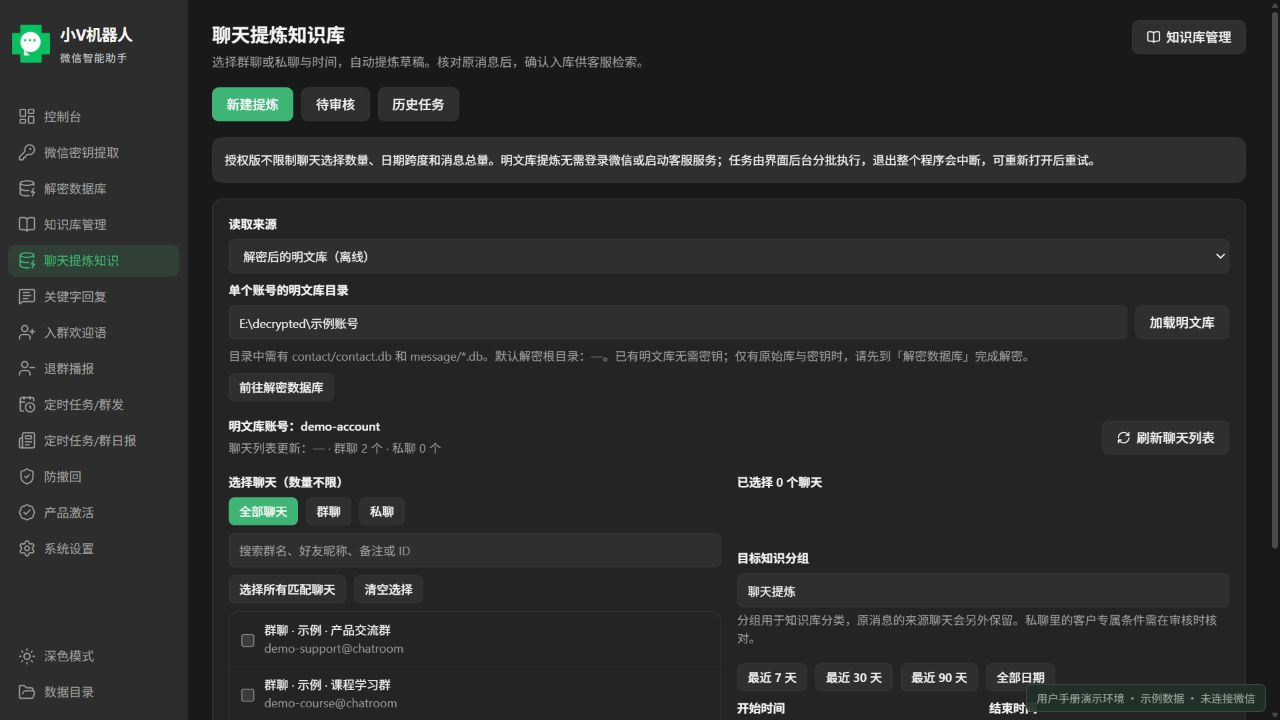
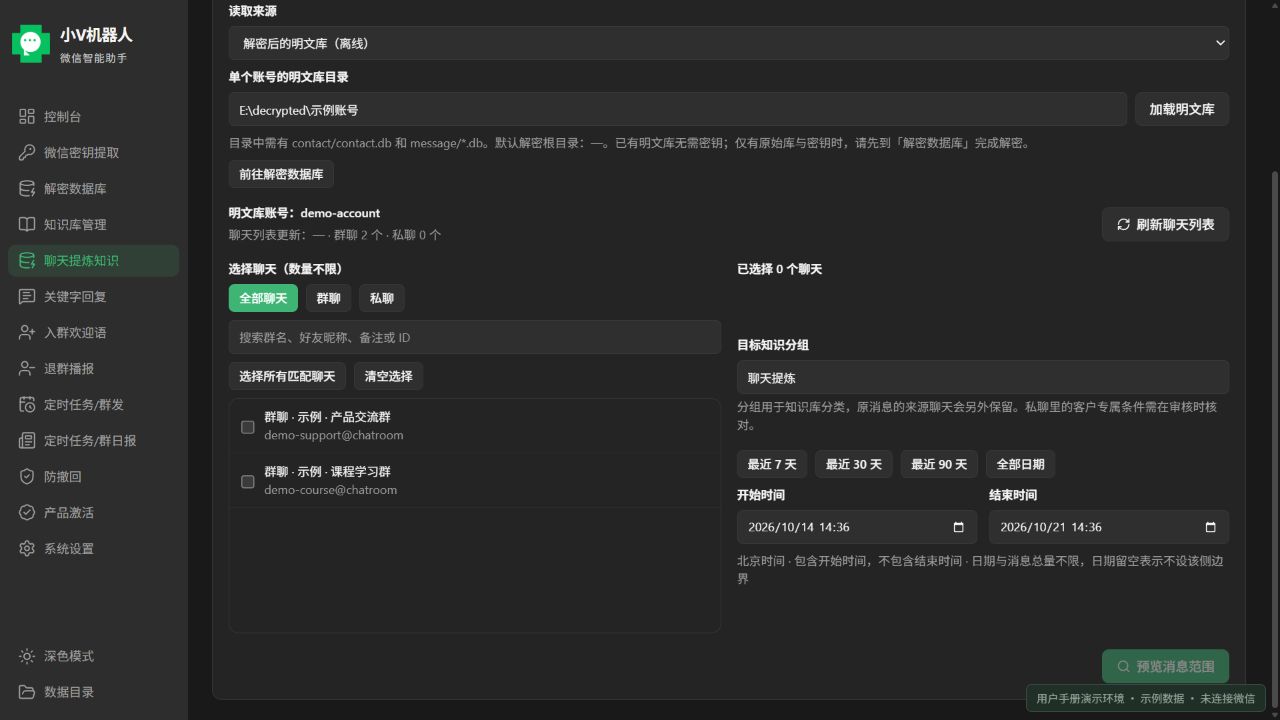
从侧栏「聊天提炼知识」进入,或点击「知识库管理」中的「从聊天提炼」。
- 通过「全部聊天 / 群聊 / 私聊」筛选,搜索群名、好友昵称、备注或 ID,勾选需要处理的聊天。支持混合选择。试用版合计最多 30 个;授权版数量不限,可用「选择所有匹配聊天」批量勾选。
- 填写目标知识分组,例如「产品售后知识」。此字段用于管理分类,来源聊天单独保存。
- 设置开始和结束时间,也可以选择最近 7 天或最近 30 天;授权版还可选择最近 90 天或全部日期。所有时间按北京时间处理,包含开始时间、不包含结束时间。要包含某一天全天,结束时间应选次日 00:00。
- 点击「预览消息范围」,等待后台读取完成。
切换菜单或刷新页面后,已选择聊天、时间范围、目标分组与聊天类型筛选会按微信账号保存在本机,可继续填写。
试用版单次最多 30 天和 10000 条消息;授权版没有这两项总量限制,起止日期可以分别留空或选择「全部日期」。大范围记录分批读取、按聊天和时间组织模型批次,内存不保存全量消息。读取失败会显示原因;不会把截断结果当作完整范围。历史未同步、缺失记录及不可读取的附件不能由程序自动补回。
自动生成草稿
检查各聊天消息统计、脱敏样本和附件数量,确认 AI 服务与模型。勾选文本处理范围说明,再点击「开始 AI 提炼」。
系统保存本轮来源快照,按来源聊天、时间间隔及内容量组织讨论批次,用模型关联讨论并提炼问答,再核查答案依据。仅提交脱敏文本与匿名发言人代号;原始文本和发言人 ID 留在本地。手机号、身份证、常见微信号与邮箱按规则脱敏,但客户名称、地址等需在样本中自行核对。
群聊与私聊分开组织讨论批次,不混合不同聊天的上下文。私聊中的客户专属报价、承诺、权限或个案处理需保留适用范围,不可直接当作通用规则;审核时需再次核对。
图片、语音、文件等保留「附件未解析」占位,供上下文识别和人工补充;第一版不包含 OCR 或语音转文字。长讨论切分时可能断开问答上下文,模型会标记风险,仍需人工核对。
实时库任务与群发、群日报共用后台队列;明文库任务使用独立持久化队列,保持 UI 后端运行即可。关闭页面不会停止任务;「停止后续处理」会保留已完成结果。正在执行的模型请求可能要等待返回或超时。模型失败可在结果页查看批次原因,再点击「重试未完成部分」。已成功批次不会重复请求模型。
人工审核和入库
在「待审核」视图逐条查看标准问题、答案、关键词、适用范围和来源证据。点击「查看讨论批次」可查看同批次前后消息;勾选查看本地原文后可对照未经脱敏的文本。
- 新增知识:保留为独立条目。同分组、同问题、同答案已存在时跳过新增;答案不同则停止发布,要求明确处理冲突。
- 排除:不入库,保存排除决定后仍可查看和恢复审核。
- 明确更新已有知识:选择提示的目标条目,保留其原标准问题,核对新旧答案后明确同意更新。已有人工答案不会自动覆盖。
置信度只是模型自评,不是答案正确率。无解法护栏、依据核查未通过、答案冲突、上下文不足或附件缺失都需人工确认与修订。
勾选「我已核对原消息」并保存修改与审核。然后选中已审核条目,点击「确认入库所选条目」。每批最多 200 条。发布时再次核对草稿版本和已有知识版本;发生冲突会取消整批写入,不留下部分覆盖。入库条目标记为 human,记录发布批次与来源证据。
完成报告显示新增、更新和重复跳过数量。当前服务刷新索引,其他使用该知识库的服务通过热重载读取变更。知识库总开关关闭时,知识虽然已保存,客服仍不会检索它。
查看历史与回退
「历史任务」保留时间范围、原消息快照、失败原因及草稿,可继续审核。服务重启导致中断的任务会标记中断,由用户重试未完成部分。
发布完成后,可点击「回退本批次」。系统恢复本批次修改前的知识,移除本批次新建的知识,并重置对应草稿审核状态。如果知识发布后又被人工修改,或被其他提炼批次关联,回退会取消,避免覆盖后续工作。
实现与验证
应用模块是 src/kb_extraction.py,不调用开发脚本,也不依赖 PyTorch;编码复用现有 RAG 编码器和 ONNX 模型。任务与草稿保存在数据目录的 kb_extraction.db,已发布知识和来源审计保存在 knowledge_base/kb.db,随现有数据备份保存。离线运行记录也保存在 kb_extraction.db;备份导入导出前需停止或等待离线提炼任务完成。
自动回归使用临时数据库和模拟微信、AI,不读真实聊天,不产生模型费用。实际微信版本适配、选定群聊和私聊的数据覆盖、模型输出质量及费用仍需用真实小范围样本验证。取消总量上限不代表处理时间或模型费用不增长;程序仍按讨论批次调用模型。